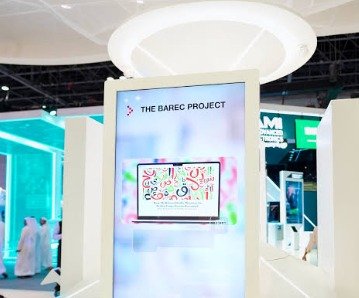

سجل مشروع “بارق” للبحث والتطوير في مجال إتاحة القراءة باللغة العربية أثرًا بحثيًا متناميًا، مع نشر 6 منشورات علمية من أصل 10 منشورات ضمن المشروع حتى الآن، حصدت نحو 80 استشهادًا علميًا، فيما ينتظر صدور 4 منشورات أخرى رسميًا بنهاية أكتوبر ومطلع نوفمبر المقبلين.
كما سجلت النماذج ومجموعات البيانات المتاحة عبر منصة “Hugging Face” نحو 28,748 عملية تنزيل، بما يعكس اهتمام المجتمع البحثي بالموارد التي يتيحها المشروع والاستفادة منها.
ويهدف مشروع “بارق” إلى تطوير مرجع شامل لإمكانية القراءة باللغة العربية، بما يسهم في تسهيل الوصول إلى المحتوى العربي وفهمه في مختلف أنحاء العالم العربي، بالتوافق مع الجهود والمناهج التي يعمل عليها مركز أبوظبي للغة العربية في مجال اللغة العربية.
ويعتمد المشروع على منهج بحثي قائم على الأدلة، من خلال تجميع ذخيرة لغوية تضم نحو 10 ملايين كلمة، تغطي مجموعة واسعة من الأنواع والموضوعات والمصادر، مع تركيز خاص على مستويات إمكانية القراءة.
ويعمل فريق المشروع على إخضاع أجزاء من هذه الذخيرة اللغوية لعمليات توصيف وتوسيم للمفردات والتراكيب المعقدة، إلى جانب بناء معجم يتضمن تعليقات توضيحية مرتبطة بمستويات إمكانية القراءة، بما يشكل أساسًا لتطوير أدوات ذكاء اصطناعي قادرة على تنفيذ عمليات التوسيم بصورة آلية على بقية الذخيرة اللغوية.
كما يتضمن المشروع تطوير أدوات إضافية للذكاء الاصطناعي للمساعدة في إنتاج وتطوير المحتوى، وتقييمه وفقًا لمعايير إمكانية القراءة.
ويقود مشروع “بارق” فريق من الخبراء والباحثين من جامعة نيويورك أبوظبي، وجامعة زايد، ومركز أبوظبي للغة العربية، برئاسة البروفيسور نزار حبش، أستاذ علوم الحاسوب في جامعة نيويورك أبوظبي، ومؤسس مختبر نمذجة اللغة العربية “CAMeL Lab”، أحد المختبرات البحثية المتخصصة في مجال الذكاء الاصطناعي للغة العربية.
ويشارك في قيادة المشروع أيضًا البروفيسورة هنا طه، مديرة مركز الذكاء الاصطناعي في جامعة زايد، ضمن فريق العمل البحثي القائم على تطوير المشروع.